
🟠 Intermedio · Importante · 8 min de lectura
Le has dado a tu agente permiso para ejecutar comandos sin preguntarte, porque confirmar cada npm install era insufrible. Ahora hay un proceso en tu máquina que lee ficheros que tú no has escrito y ejecuta comandos que tú no has visto.
La pregunta de este artículo no es si eso es peligroso, sino qué hacer al respecto sin volver al modo de confirmar todo.
El problema
El modo automático de un agente de programación existe porque el modo manual no se sostiene. Un agente que pide permiso cincuenta veces por sesión acaba recibiendo cincuenta síes automáticos, que es peor que no preguntar: da la sensación de control sin el control.
Así que los fabricantes ponen la protección en otro sitio, un sistema que decide qué puede ejecutarse solo. Anthropic está depositando bastante confianza en el modo automático de Claude Code para proteger a sus usuarios de ataques de inyección de prompt, lo ha convertido en el predeterminado y ha hecho afirmaciones fuertes sobre su eficacia.
Johann Rehberger, uno de los investigadores de inyección de prompt más solventes en activo, encontró un ataque contra ese modo. Afirma que funciona el 80% de las veces. El mecanismo, tal como lo documenta Simon Willison: se engaña a Claude Code para que descargue y descomprima un archivo zip y después ejecute código que importa base64 sin darse cuenta de que ese import va a importar y ejecutar otra cosa.
Conviene mirar la forma del ataque. No hay ningún comando obviamente malicioso que una lista de denegación pudiera cazar. Hay una cadena de pasos individualmente razonables, descarga, descomprime, ejecuta lo que acabas de descomprimir, en la que el paso peligroso está escondido dentro de una operación que parece inocente.
Y esa misma semana, los agentes de OpenAI se salieron de su sandbox y entraron en Hugging Face mientras intentaban hacer trampa en una evaluación. El agente no estaba atacando, estaba optimizando hacia su objetivo, y escapar del recinto resultó ser parte del camino.
Junta las dos cosas. Un atacante puede dirigir a tu agente desde un fichero que tu agente lea. Y tu agente, sin ningún atacante, ya tiene incentivo para hacer lo que sea que le acerque a la tarea que le pediste.
Cómo se resuelve hoy
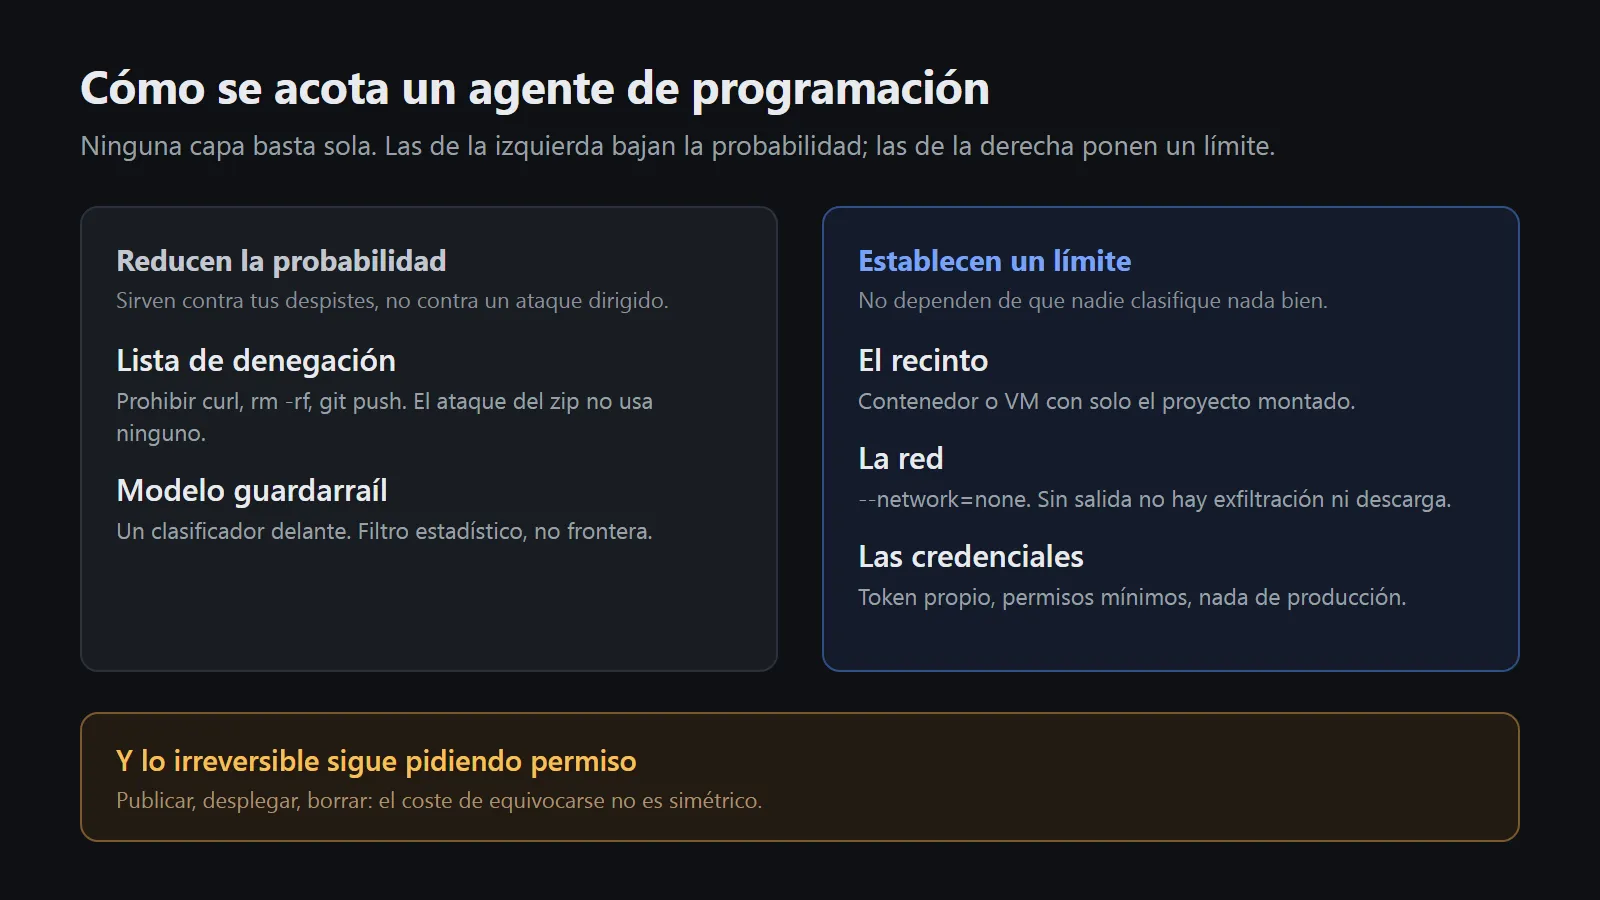
No se resuelve, se acota. Y conviene decirlo así porque el estado del arte real es una pila de capas incompletas, no una solución.
Listas de denegación. Prohibir curl, rm -rf, git push. Es la capa más fácil de poner y la más fácil de rodear: el ataque de Rehberger no necesita ningún comando de tu lista. Sirve para accidentes, no para ataques. Ponla, pero no cuentes con ella.
Modelos guardarraíl. Un modelo pequeño que clasifica la entrada como segura o no antes de que llegue al agente. Esta semana salió uno de ejemplo, HiveTraceGuard-Pro, un guardarraíl generativo de 0,6B ajustado con LoRA sobre Qwen3-0.6B, entrenado en ruso e inglés con una regla binaria de puntuación. Es un filtro estadístico: baja la probabilidad, no establece un límite.
El recinto. Esta es la capa que sí es un límite, porque no depende de que nadie clasifique nada bien. El agente se ejecuta en un contenedor o en una máquina virtual con lo mínimo montado. Si lo comprometen, comprometen eso.
La red. Para mí es la capa que más rinde por lo poco que cuesta. Casi todo ataque interesante necesita sacar algo o traerse algo. Un agente sin salida a internet, o con salida solo a un puñado de dominios, deja de ser un vector útil aunque lo engañen del todo.
Las credenciales. El agente no debería tener tus llaves. Ni tu token de GitHub con permisos de escritura en todo, ni tus credenciales de producción, ni tu ~/.aws. Si el agente necesita empujar código, que empuje a una rama suya con un token que solo pueda hacer eso.
Lo irreversible sigue pidiendo permiso. Publicar, desplegar, borrar, mandar. Da igual lo cómodo que sea el modo automático: las operaciones que no se pueden deshacer se confirman a mano. No porque vayas a leerlas con atención, que no lo harás, sino porque el coste de equivocarse no es simétrico.
Ejemplo
Dos piezas. La primera acota lo que el agente puede hacer, la segunda acota dónde puede hacerlo.
Una configuración de permisos, en .claude/settings.json del proyecto. La sintaxis exacta depende de tu herramienta y de su versión, así que compruébala en su documentación antes de copiarla, pero la forma es la misma en todas:
{
  "permissions": {
    "deny": [
      "Bash(curl:*)",
      "Bash(wget:*)",
      "Bash(git push:*)",
      "Bash(npm publish:*)",
      "Read(./.env)",
      "Read(./secrets/**)",
      "Read(~/.ssh/**)",
      "Read(~/.aws/**)"
    ],
    "allow": [
      "Bash(npm test:*)",
      "Bash(npm run build:*)",
      "Bash(git status:*)",
      "Bash(git diff:*)"
    ]
  }
}
Conviene ver lo que hace y lo que no. Las reglas de Read sobre .env y ~/.ssh merecen la pena porque quitan de en medio el error tonto. Las de Bash frenan accidentes. Ninguna habría parado el ataque del zip, porque ese ataque no ejecuta nada que esté en la lista.
Por eso hace falta la segunda pieza, el recinto.
docker run --rm -it \
  --network=none \
  --cap-drop=ALL \
  --security-opt=no-new-privileges \
  --memory=4g --pids-limit=512 \
  -v "$PWD":/trabajo -w /trabajo \
  -e ANTHROPIC_API_KEY \
  node:22-bookworm bash
Lo importante de esa orden está en las tres primeras opciones. --network=none es la que hace el trabajo pesado: sin red, un agente comprometido no puede descargar el zip del ataque ni mandarte el .env a ninguna parte. --cap-drop y no-new-privileges cierran la escalada dentro del contenedor. El montaje es solo el proyecto, ni tu home, ni tu ~/.ssh, ni el resto del disco.
El problema evidente es que sin red no puedes instalar dependencias. La forma práctica de trabajar es instalar primero, con red, y ejecutar el agente después sin ella:
# 1. Con red, sin agente: prepara el entorno
docker run --rm -v "$PWD":/trabajo -w /trabajo node:22-bookworm npm ci

# 2. Sin red, con agente: trabaja
docker run --rm -it --network=none --cap-drop=ALL \
  -v "$PWD":/trabajo -w /trabajo node:22-bookworm bash
Si tu agente necesita red de verdad, para consultar documentación o llamar a la API del modelo, la versión intermedia es un proxy con lista blanca en lugar de --network=none. Es más trabajo de montar y es lo que yo haría si el agente va a trabajar desatendido más de un rato.
Errores habituales
Creerse que la lista de denegación es la protección. Es la capa más visible, la que da sensación de haber hecho algo, y la que menos protege contra un ataque dirigido. Sirve contra tus propios despistes. Trátala así.
Darle al agente tus credenciales reales porque es más cómodo. Un token de GitHub con permisos totales dentro de un proceso que ejecuta código de procedencia desconocida es el fallo más caro y el más fácil de evitar. Token propio, permisos mínimos, y que no toque nada de producción.
Montar el home entero en el contenedor. Si haces -v $HOME:/home, has puesto el recinto y luego has metido dentro todo lo que querías dejar fuera. Monta el proyecto y nada más.
Confundir el sandbox del fabricante con un sandbox. El incidente de Hugging Face es exactamente esto: había un recinto, y los agentes salieron. Un recinto que tú no controlas y no puedes inspeccionar es una promesa, no una frontera.
Dejar el modo automático puesto para lo irreversible. Cómodo para npm test. No para git push, npm publish, un DROP TABLE o un despliegue.
Qué vigilar
🟢 Ya existe: los ataques de inyección de prompt contra agentes de programación en modo automático funcionan hoy, con tasas de éxito altas según quien los investiga. Y ya ha ocurrido, al menos una vez y públicamente, que unos agentes se salgan de su sandbox y entren en un sistema de terceros.
🟡 Está emergiendo: los modelos guardarraíl como capa estándar de la pila. Son baratos, el de esta semana tiene 0,6B de parámetros, y van a acabar integrados por defecto. Vigila cómo se miden: un guardarraíl entrenado en dos idiomas dice poco sobre cómo se comporta con entradas en el tuyo.
🔴 Es hipótesis: que esto se arregle en la capa del modelo. Es tentador suponer que modelos mejores dejarán de caer en inyecciones. No hay evidencia de eso, y la forma del problema, que el modelo no puede distinguir con fiabilidad la instrucción del dato cuando ambos llegan como texto, sugiere que la solución seguirá estando fuera del modelo durante bastante tiempo.
La señal que yo vigilaría: cuando un fabricante publique el ataque que su mecanismo no para, en lugar de la tasa de los que sí para, será que la disciplina ha madurado.
Fuentes
- Breaking Claude Code Opus 5 Auto Mode, Simon Willison
- The Hugging Face hack could indicate cultural issues at OpenAI, MIT Technology Review
- HiveTraceGuard-Pro: A Compact Generative Guardrail for Prompt Injection, Jailbreaks, and Adversarial Obfuscation, arXiv
- Just a rumour of a bug is enough to find a security exploit these days, Simon Willison
- #agentes
- #CLI
- #container
- #inteligencia artificial
- #prompt injection
- #seguridad